Apple
Apple A12 Bionic के अंदर क्या है और यह चिप कैसी बनी है?

A12 Bionic पहली बार 2018 में iPhone XS और iPhone XS Max के साथ सामने आई थी, और कुछ ही समय बाद यह iPhone XR में भी पहुंच गई। उस वक्त सबसे ज्यादा बात 7 नैनोमीटर की निर्माण प्रक्रिया को लेकर हुई थी, लेकिन A12 की असली कहानी सिर्फ इतनी नहीं है। इसके अंदर अलग-अलग काम के लिए बनाए गए कई हिस्से मौजूद हैं, और इन सबका साथ मिलकर काम करना ज्यादा दिलचस्प है।
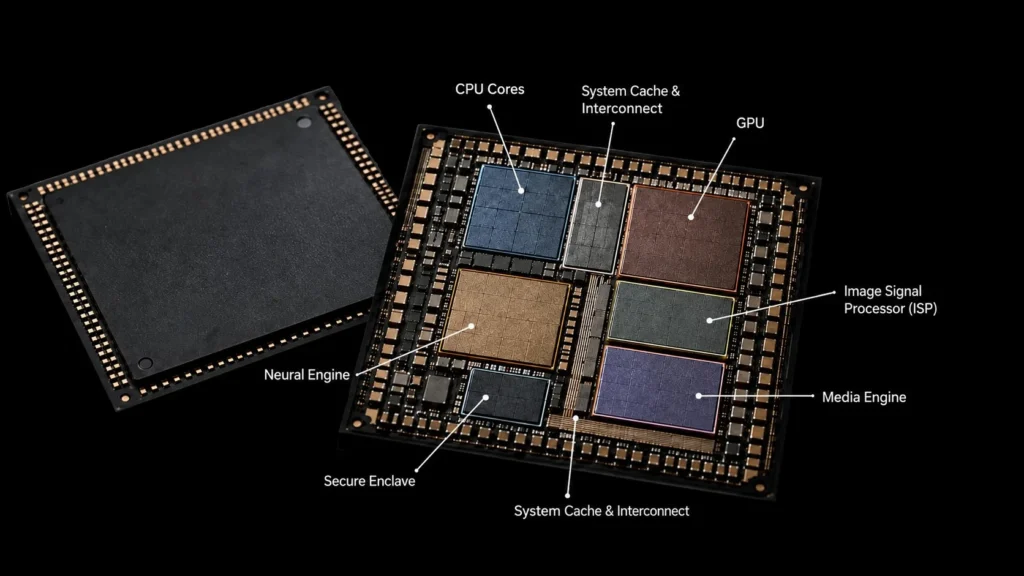
A12 में छह CPU कोर, चार GPU कोर और आठ कोर वाला Neural Engine है। इसे 7 नैनोमीटर प्रक्रिया पर बनाया गया था, और इसके साथ ही इसमें Apple का इमेज सिग्नल प्रोसेसर, वीडियो एनकोडर और तेज मेमोरी कंट्रोलर भी शामिल हैं। लेकिन सिर्फ इन नामों को पढ़ लेने से A12 समझ में नहीं आती — इसके लिए चिप को ऊपर से नीचे तक देखना पड़ता है।
A12 बाहर से कैसी दिखती है
फोन के मदरबोर्ड पर लगी A12 को देखने पर सबसे पहले उसका बाहरी पैकेज नजर आता है, जबकि असली गणना करने वाला सिलिकॉन उसके अंदर छिपा होता है। इस सिलिकॉन हिस्से को डाई कहते हैं, और यहीं पर ट्रांजिस्टर और उनसे बने परिपथ मौजूद होते हैं — यानी वह जगह जहां CPU गणना करता है, GPU ग्राफिक्स संभालता है, और Neural Engine मशीन लर्निंग से जुड़ा काम करता है।
TechInsights ने iPhone XS Max को खोलकर A12 के पैकेज और डाई का अध्ययन किया था। उनके मुताबिक A12 को Package on Package व्यवस्था में 4 GB LPDDR4X मेमोरी के साथ रखा गया था, और अलग-अलग यूनिट्स में Micron व Samsung दोनों के मेमोरी घटक देखे गए।
7 नैनोमीटर का मतलब क्या है
Apple ने A12 को स्मार्टफोन में इस्तेमाल होने वाली पहली 7 नैनोमीटर चिप के तौर पर पेश किया था। यहां एक बात समझनी जरूरी है — 7 नैनोमीटर का मतलब यह नहीं कि पूरी चिप की लंबाई-चौड़ाई 7 नैनोमीटर है। यह असल में चिप बनाने की तकनीकी पीढ़ी को दर्शाता है।
नई निर्माण प्रक्रिया में बहुत छोटे ट्रांजिस्टरों को कहीं ज्यादा पास-पास रखा जा सकता है, जिससे सीमित जगह में अधिक परिपथ फिट हो जाते हैं और डिजाइन को ऊर्जा खपत के हिसाब से बेहतर बनाया जा सकता है। A12 में यही बात अहम थी — Apple ने परफॉर्मेंस बढ़ाने के साथ-साथ ऊर्जा की बचत पर भी उतना ही जोर दिया।
चिप के अंदर असली काम कौन करता है
A12 को समझने का सबसे आसान तरीका है इसके हिस्सों को अलग-अलग करके देखना। CPU सामान्य गणना संभालता है, GPU ग्राफिक्स और एक जैसी बड़ी संख्या में गणनाएं करता है, और Neural Engine खास तौर पर मशीन लर्निंग के लिए बनाया गया है। इसके अलावा इमेज सिग्नल प्रोसेसर कैमरे से आने वाली जानकारी को प्रोसेस करता है, वीडियो एनकोडर वीडियो का काम संभालता है, और मेमोरी कंट्रोलर चिप व मुख्य मेमोरी के बीच डेटा के आवागमन का जिम्मा उठाता है। इन सबके बीच एक साझा व्यवस्था भी होती है जो हर हिस्से को आपस में जोड़े रखती है।
यही वजह है कि A12 को सिर्फ CPU कहना सही नहीं होगा — यह असल में एक SoC है, जिसमें कई तरह के गणना और नियंत्रण वाले हिस्से एक ही सिलिकॉन पर मौजूद हैं।
A12 का CPU
A12 में छह CPU कोर हैं — दो हाई-परफॉर्मेंस Vortex कोर और चार एनर्जी-एफिशिएंट Tempest कोर। Apple के मुताबिक Vortex कोर पिछली पीढ़ी से 15 प्रतिशत तक तेज थे, जबकि Tempest कोर 50 प्रतिशत तक ज्यादा एफिशिएंट बताए गए थे।
Vortex उन कामों के लिए हैं जहां कम समय में ज्यादा गणना करनी होती है, जबकि Tempest छोटे और कम बिजली खर्च करने वाले कोर हैं जो हल्के कामों के लिए काफी होते हैं — आखिर हर छोटे टास्क के लिए बड़े कोर चलाने की जरूरत नहीं। मान लीजिए आप सिर्फ मैसेज पढ़ रहे हैं, तो फोन को पूरी गणना शक्ति की जरूरत नहीं होती, लेकिन कोई भारी गेम चल रहा हो या कोई जटिल काम हो तो तेज कोरों की डिमांड अपने आप बढ़ जाती है। A12 का डिजाइन इसी संतुलन के इर्द-गिर्द बना है — अलग-अलग तरह के कामों के हिसाब से गणना शक्ति और ऊर्जा खपत के बीच तालमेल बिठाना।
Vortex और Tempest के बीच फर्क सिर्फ स्पीड का नहीं है। Vortex कोर बड़े और ज्यादा जटिल हैं, जबकि Tempest कोर छोटे आकार में हल्के काम के लिए डिजाइन किए गए हैं। AnandTech के परीक्षण में Tempest की आंतरिक बनावट और उसके कॉम्पैक्ट साइज का काफी बारीकी से अध्ययन किया गया था, साथ ही यह भी देखा गया कि ये छोटे कोर अपने काम के लिए किस तरह की गणना व्यवस्था रखते हैं। इससे एक जरूरी बात समझ आती है — एक अच्छी मोबाइल चिप बनाने का मतलब सिर्फ सबसे तेज कोर डाल देना नहीं है, बल्कि असली चुनौती यह है कि जरूरत पड़ने पर तेज कोर मौजूद हों और बाकी समय कम से कम ऊर्जा खर्च हो।
CPU चाहे कितना भी तेज क्यों न हो, अगर उसे बार-बार मुख्य मेमोरी से डेटा मंगाना पड़े तो उसका बहुत सा समय इंतजार में ही निकल जाता है। इसीलिए चिप में तेज मेमोरी के अलग-अलग स्तर रखे जाते हैं। AnandTech के विश्लेषण में A12 की मेमोरी व्यवस्था में हुए बदलावों को इसके परफॉर्मेंस सुधार की एक बड़ी वजह माना गया था — सीधे शब्दों में कहें तो CPU को जरूरी डेटा जितनी जल्दी मिलता है, उतना ही कम समय उसे मुख्य मेमोरी तक जाने में खर्च करना पड़ता है।
GPU का काम
A12 में चार GPU कोर हैं, जिन्हें Apple ने A11 के मुकाबले 50 प्रतिशत तक तेज बताया था। लेकिन GPU का काम सिर्फ गेम्स में ग्राफिक्स बनाना नहीं है — स्क्रीन पर दिखने वाले कई विजुअल इफेक्ट्स के पीछे भी GPU की ही गणना होती है। 3D दृश्य, लाइटिंग, शैडो, और इस तरह की ढेर सारी समान गणनाओं को एक साथ संभालना GPU की असली ताकत है, और यही वजह है कि A12 का GPU गेमिंग के अलावा फोटो और दूसरे विजुअल कामों में भी बराबर काम आता है।
Neural Engine क्यों जोड़ा गया
A12 का Neural Engine शायद इस चिप का सबसे बड़ा बदलाव था। इसमें आठ कोर हैं, और Apple के मुताबिक यह प्रति सेकंड 5 खरब तक गणनाएं कर सकता है — जबकि A11 का Neural Engine सिर्फ 600 अरब गणनाएं प्रति सेकंड तक ही संभाल पाता था।
यह किसी सामान्य CPU की जगह लेने के लिए नहीं बनाया गया, बल्कि इसका मकसद ऐसे मशीन लर्निंग हिसाब को तेजी से पूरा करना था जिनमें एक साथ बहुत सारी गणनाएं करनी पड़ती हैं — जैसे किसी तस्वीर में अलग-अलग हिस्सों को पहचानना, चेहरे से जुड़ी जानकारी समझना, या ऑगमेंटेड रियलिटी में किसी सतह को पहचानना। A12 के साथ ही Apple ने पहली बार Neural Engine को Core ML के जरिए सीधे डेवलपर्स के लिए उपलब्ध भी कराया, जिससे ऐप बनाने वाले लोग मशीन लर्निंग का काम सीधे इसी खास हिस्से पर चला सकते थे।
कैमरे की तस्वीर में A12 कहां काम आती है
जब आप iPhone XS से फोटो खींचते हैं, तो सिर्फ कैमरा सेंसर ही काम नहीं कर रहा होता। सेंसर लाइट से जुड़ी जानकारी देता है, और उसके बाद इस जानकारी को कई चरणों में प्रोसेस करना पड़ता है। A12 में मौजूद इमेज सिग्नल प्रोसेसर यही काम संभालता है — Apple ने इसके साथ Smart HDR, डेप्थ से जुड़ी जानकारी, और मशीन लर्निंग आधारित इमेज प्रोसेसिंग पर भी जोर दिया था।
सीधे शब्दों में कहें तो कैमरा सेंसर जानकारी देता है, इमेज सिग्नल प्रोसेसर उसे व्यवस्थित करता है, Neural Engine कुछ पहचान और मशीन लर्निंग वाले काम करता है, CPU जरूरी कंट्रोल और गणना संभालता है, और GPU कुछ विजुअल गणनाओं में योगदान देता है। इसके बाद कहीं जाकर फोटो तैयार होती है। असली प्रक्रिया इससे कहीं ज्यादा जटिल है, लेकिन इस तरह देखने पर यह समझना आसान हो जाता है कि एक फोटो बनाने में अकेला कैमरा जिम्मेदार नहीं होता।
A12 और मेमोरी का रिश्ता
iPhone XS Max के TechInsights परीक्षण में A12 के ऊपर 4 GB LPDDR4X मेमोरी Package on Package व्यवस्था में मिली थी — यानी मुख्य चिप और उसकी वर्किंग मेमोरी को एक-दूसरे के बेहद करीब रखा गया। जब CPU, GPU या दूसरे हिस्सों को काम के लिए जानकारी चाहिए होती है, तो मेमोरी से लगातार डेटा आता-जाता रहता है।
इसलिए चिप का परफॉर्मेंस सिर्फ उसके CPU और GPU पर निर्भर नहीं करता — मेमोरी तक जानकारी कितनी जल्दी पहुंचती है और अलग-अलग हिस्से उस जानकारी का कितना असरदार इस्तेमाल करते हैं, यह भी उतना ही मायने रखता है।
सुरक्षा वाला हिस्सा
फोन में सिर्फ फोटो और ऐप्स नहीं होते, बल्कि यूजर की निजी जानकारी भी होती है। Apple ने A12 वाले iPhone में Face ID और सुरक्षित ऑथेंटिकेशन के लिए Secure Enclave जैसी सुरक्षा व्यवस्था इस्तेमाल की थी — Apple के मुताबिक TrueDepth और Secure Enclave मिलकर Face ID की सुरक्षा का आधार बनते थे। यानी चिप का काम सिर्फ फोन को तेज बनाना नहीं है, उसे यह भी सुनिश्चित करना होता है कि संवेदनशील जानकारी सुरक्षित तरीके से संभाली जाए।
एक ही चिप में इतने सारे हिस्से क्यों
यही SoC की सबसे खास बात है। अगर CPU, GPU, मशीन लर्निंग की गणना, इमेज प्रोसेसिंग और बाकी हिस्से पूरी तरह अलग-अलग चिप्स में होते, तो उनके बीच डेटा भेजने के लिए अलग रास्तों की जरूरत पड़ती। मोबाइल फोन में जगह और ऊर्जा दोनों ही सीमित हैं, इसलिए इतने सारे जरूरी हिस्सों को एक ही सिलिकॉन पर रखना कहीं ज्यादा समझदारी वाला तरीका है।
A12 में इन सब हिस्सों को साथ रखकर Apple ने सिर्फ ज्यादा गणना शक्ति देने की कोशिश नहीं की, बल्कि यह भी सुनिश्चित किया कि हर काम के लिए सही गणना हिस्सा इस्तेमाल हो। यही वजह है कि एक साधारण फोटो लेते वक्त भी A12 के कई हिस्से अलग-अलग भूमिका निभा रहे होते हैं।
डाई पर क्या-क्या दिखाई देता है
TechInsights और AnandTech के अध्ययन से A12 की डाई पर अलग-अलग बड़े हिस्सों की स्थिति का पता चलता है — CPU के लिए अलग जगह, GPU के लिए अलग जगह, और Neural Engine के लिए एक बड़ा क्षेत्र। बीच में साझा तेज मेमोरी से जुड़े हिस्से भी नजर आते हैं।
इससे एक दिलचस्प बात सामने आती है — डाई पर सबसे बड़ा हिस्सा हमेशा CPU ही हो, ऐसा जरूरी नहीं। आधुनिक चिप में ऐसे कई हिस्से होते हैं जो किसी सामान्य CPU कोर से बिल्कुल अलग काम करते हैं, इसीलिए सिर्फ CPU कोर की गिनती देखकर पूरी चिप की क्षमता आंकना मुश्किल है।
ट्रांजिस्टर से लेकर पूरी चिप तक का सफर
सबसे नीचे ट्रांजिस्टर होते हैं। इनसे लॉजिक सर्किट बनते हैं, इन सर्किट्स से गणना करने वाली छोटी इकाइयां बनती हैं, और इन इकाइयों को जोड़कर CPU कोर, GPU कोर और बाकी खास हिस्से तैयार होते हैं। फिर इन सभी हिस्सों को मेमोरी, साझा कम्युनिकेशन व्यवस्था और दूसरे कंट्रोलर्स से जोड़ा जाता है — और तब जाकर सामने आती है A12 जैसी पूरी SoC।
यानी जब हम कहते हैं कि A12 में अरबों ट्रांजिस्टर हैं, तो असली बात सिर्फ उनकी गिनती में नहीं है। असली महत्व इस बात में है कि इन्हें किस तरह व्यवस्थित करके एक उपयोगी गणना व्यवस्था बनाई गई है।
A12 और A11 में असली फर्क क्या था
A12 को समझने के लिए सिर्फ यह देखना काफी नहीं कि दोनों में छह-छह CPU कोर थे — A11 में भी उतने ही कोर थे। असली बदलाव कहीं और आया: निर्माण प्रक्रिया 10 नैनोमीटर से घटकर 7 नैनोमीटर हुई, GPU तीन कोर से बढ़कर चार कोर का हो गया, और Neural Engine दो कोर से सीधे आठ कोर तक पहुंच गया। साथ ही Apple ने CPU और GPU की एफिशिएंसी में भी सुधार का दावा किया था।
तो A12 का सुधार सिर्फ CPU कोर की गिनती बढ़ाने से नहीं आया — असल में चिप के कई हिस्सों को एक साथ बेहतर बनाया गया।
A12X और A12Z की कहानी
A12 परिवार की एक दिलचस्प कड़ी है A12X और A12Z। A12X को iPad Pro के लिए बनाया गया था, जिसमें चार हाई-परफॉर्मेंस Vortex कोर, चार एनर्जी-एफिशिएंट Tempest कोर, और सात-कोर वाला GPU था। इसके बाद आया A12Z।
TechInsights ने A12X और A12Z की डाई की तुलना की और दोनों का साइज एक जैसा — 10.1 मिलीमीटर गुणा 12.6 मिलीमीटर — पाया, और दोनों की आंतरिक बनावट भी लगभग समान थी। फर्क सिर्फ इतना था कि A12X में आठ में से सात GPU कोर एक्टिव थे, जबकि A12Z में सभी आठों को एक्टिव कर दिया गया। इससे एक दिलचस्प बात पता चलती है — किसी नई चिप का नया नाम हमेशा पूरी तरह नए सिलिकॉन डिजाइन का सबूत नहीं होता। कभी-कभी एक ही मूल डिजाइन में कोई हिस्सा एक्टिव या डिएक्टिव करके अलग प्रोडक्ट तैयार कर दिया जाता है।
A12 किन डिवाइसेज में आई
A12 सबसे पहले iPhone XS और iPhone XS Max में आई, फिर iPhone XR में इस्तेमाल हुई। बाद में Apple ने इसे iPad Air, iPad mini और आठवीं पीढ़ी के iPad में भी लगाया।
पूरी बात को एक तस्वीर के जरिए समझें
अगर पूरी चिप को एक साथ समझना हो, तो एक फोटो खींचने की प्रक्रिया इसका सबसे अच्छा उदाहरण है। आप कैमरा खोलते हैं, सेंसर दृश्य की जानकारी लेता है, इमेज सिग्नल प्रोसेसर उसे प्रोसेस करता है, मशीन लर्निंग वाले काम Neural Engine तक पहुंच जाते हैं, CPU बाकी जरूरी गणना और कंट्रोल संभालता है, GPU कुछ विजुअल गणनाओं में योगदान देता है, मेमोरी इन सबके बीच जरूरी डेटा उपलब्ध कराती है, और सुरक्षा वाला हिस्सा संवेदनशील जानकारी को सुरक्षित रखता है। आखिर में आपको सिर्फ एक फोटो दिखाई देती है
A12 को सिर्फ एक तेज प्रोसेसर कहना इसके साथ न्याय नहीं होगा। यह एक ऐसी एकीकृत चिप है जिसमें सामान्य गणना, ग्राफिक्स, मशीन लर्निंग, वीडियो, मेमोरी और सुरक्षा जैसे अलग-अलग कामों के लिए अलग हिस्से मौजूद हैं। 2018 में इसकी अहमियत सिर्फ 7 नैनोमीटर प्रक्रिया तक सीमित नहीं थी — असली बदलाव यह था कि Apple ने इन सारे हिस्सों को एक ही सिलिकॉन पर कैसे जोड़ा और उनके बीच काम कैसे बांटा। A12 की असली Anatomy इसी पूरे design में छिपी है।


2020 में Apple ने Mac की सबसे बड़ी चीज बदली, लेकिन बदलाव सिर्फ इतना नहीं था कि Intel का प्रोसेसर हटाकर Apple की चिप लगा दी गई।
असल बदलाव यह था कि Mac के अंदर अलग-अलग काम करने वाले कई हिस्सों को एक ही silicon में इस तरह जोड़ा गया कि CPU, GPU, memory और दूसरे accelerators एक-दूसरे के बहुत करीब रहकर काम कर सकें।
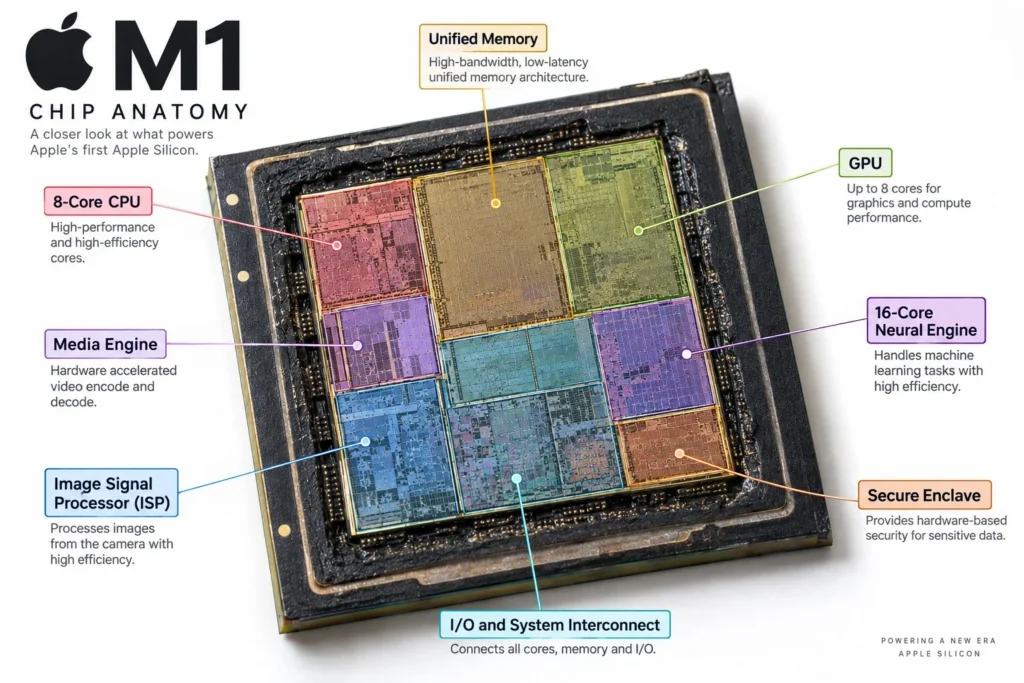
Apple ने M1 को 2020 में MacBook Air, 13-inch MacBook Pro और Mac mini के साथ पेश किया था। यह Mac के लिए Apple का पहला chip था और 5nm process पर बना था। इसमें लगभग 16 अरब transistors थे। लेकिन केवल transistor count से यह समझ में नहीं आता कि M1 इतना महत्वपूर्ण क्यों था।
Intel से Apple Silicon तक जाने की जरूरत क्यों पड़ी
M1 से पहले Mac में processor, memory और दूसरे system functions का रास्ता आज के Apple Silicon जैसा एकीकृत नहीं था।
Apple पहले से iPhone और iPad के लिए अपनी A-series chips बना रहा था। उन chips में performance और power consumption को साथ लेकर चलने का काफी अनुभव Apple के पास जमा हो चुका था।
M1 में उसी सोच को Mac के लिए बड़े स्तर पर इस्तेमाल किया गया। इसलिए M1 को केवल एक नया CPU कहना सही नहीं होगा। यह एक पूरा SoC था, जिसमें computing, graphics, machine learning, security, media और दूसरे system functions एक ही chip में रखे गए थे।
यहीं से M1 का डिजाइन समझना शुरू होता है।
M1 के अंदर असल में क्या-क्या था
M1 के मुख्य हिस्सों को देखें तो इसमें 8-core CPU, अधिकतम 8-core GPU और 16-core Neural Engine था।
CPU के 8 cores दो तरह के थे:
| CPU हिस्सा | संख्या | मुख्य काम |
| Performance cores | 4 | भारी और demanding काम |
| Efficiency cores | 4 | हल्के और कम power वाले काम |
इसके अलावा chip में GPU, Neural Engine, image signal processor, media processing के लिए dedicated hardware, Secure Enclave और दूसरे custom blocks भी मौजूद थे।
MacBook Air के कुछ M1 configurations में 7-core GPU था, जबकि दूसरे models में 8-core GPU दिया गया। MacBook Pro और Mac mini के M1 models में 8-core GPU था।
इसलिए “M1 में 8-core GPU था” कहना हर M1 Mac के लिए सही नहीं होगा।
CPU में 4 बड़े और 4 छोटे cores रखने का मतलब
M1 का CPU एक ही तरह के आठ cores से नहीं बना था।
चार performance cores तब काम आते हैं जब Mac को ज्यादा processing power चाहिए। उदाहरण के लिए बड़ी calculation, फोटो editing या कोई ऐसा काम जिसमें कम समय में ज्यादा processing करनी हो।
दूसरी तरफ चार efficiency cores कम power में रोजमर्रा के काम संभाल सकते हैं। वेब browsing, हल्का background work या दूसरे छोटे tasks के लिए हर बार चार बड़े cores चलाना जरूरी नहीं होता। यही arrangement laptop में एक महत्वपूर्ण फायदा देता है। हर काम के लिए maximum power खर्च करने की जरूरत नहीं पड़ती।
Apple के अनुसार M1 के चारों performance cores मिलकर multithreaded workloads को संभाल सकते हैं, जबकि efficiency cores बहुत कम power में हल्के काम चला सकते हैं।
M1 का सबसे बड़ा बदलाव CPU नहीं था
बड़ा बदलाव memory के तरीके में था। पुराने computer architecture में CPU और GPU जैसे processors अपने काम के दौरान memory में मौजूद data के साथ काम करते हैं और अलग-अलग हिस्सों के बीच data movement performance पर असर डाल सकता है।
M1 में Apple ने Unified Memory Architecture इस्तेमाल की।
इसमें CPU, GPU और SoC के दूसरे हिस्से एक ही memory pool को access कर सकते हैं। इसका मतलब यह है कि एक component के लिए मौजूद data को दूसरे component के लिए अलग memory pool में बार-बार copy करने की जरूरत कम हो सकती है।
मान लो कोई बड़ी image GPU process कर रहा है और CPU को उसी data पर कुछ calculation करनी है। M1 का design दोनों को उसी shared memory system से data तक पहुंचने देता है। यहीं M1 का SoC design रोजमर्रा के काम में दिखाई देता है।
लेकिन Unified Memory का एक दूसरा असर भी था
इस architecture का फायदा यह था कि memory system chip के बाकी हिस्सों के साथ शुरू से ही एक ही design का हिस्सा था।
लेकिन इसका नुकसान भी था। M1 Mac में memory सामान्य desktop RAM की तरह बाद में बदलने या upgrade करने के लिए नहीं थी। MacBook Air और MacBook Pro के शुरुआती M1 configurations 8GB या 16GB unified memory के साथ आते थे। इसलिए M1 खरीदते समय memory capacity पहले ही तय करनी पड़ती थी।
GPU को अलग graphics card की जरूरत क्यों नहीं पड़ी
M1 में dedicated GPU chip के बजाय उसी SoC के अंदर GPU मौजूद था।
8-core GPU वाला M1 Apple के अनुसार लगभग 2.6 TFLOPS तक throughput दे सकता था और एक साथ बड़ी संख्या में threads संभाल सकता था। इसका फायदा यह था कि CPU और GPU के बीच data movement के लिए अलग graphics chip और अलग memory architecture की जरूरत नहीं थी।
लेकिन इसका मतलब यह नहीं था कि M1 हर dedicated desktop GPU से तेज था। M1 का लक्ष्य कम power में बहुत अच्छा integrated performance देना था। इसी वजह से MacBook Air जैसे thin laptop में इसका design खास तौर पर उपयोगी बना।
Neural Engine Mac में पहली बार आया
M1 में 16-core Neural Engine था। यह machine learning workloads के लिए बनाया गया dedicated hardware था और Apple ने इसकी क्षमता 11 trillion operations per second तक बताई थी।
इसका इस्तेमाल उन workloads में किया जा सकता है जहां सामान्य CPU को हर calculation अकेले करने की जरूरत नहीं होती। Image processing, voice recognition और video analysis जैसे कामों में machine learning acceleration उपयोगी हो सकता है।
M1 की खास बात यह भी थी कि machine learning केवल Neural Engine तक सीमित नहीं थी। Apple ने CPU और GPU में भी ML acceleration capabilities शामिल की थीं। इसलिए M1 में AI processing को एक अलग छोटे हिस्से की कहानी समझना अधूरा होगा।
Secure Enclave और बाकी हिस्से कहां जाते हैं
M1 सिर्फ CPU, GPU और Neural Engine का जोड़ नहीं था। इसमें Secure Enclave भी था, जो security-related operations के लिए इस्तेमाल होता है। इसके अलावा image signal processing और media processing के लिए dedicated hardware मौजूद था।
इस तरह का dedicated hardware एक सामान्य CPU को हर काम करने से बचाता है।अगर video encode या decode करना हो, image processing करनी हो या security-related operation चलाना हो, तो उसके लिए specialized hardware इस्तेमाल किया जा सकता है। यही chip design की एक महत्वपूर्ण सोच है
5nm और 16 अरब transistors का मतलब
M1 को TSMC के 5nm process पर बनाया गया था और Apple ने इसमें 16 billion transistors बताए थे।
लेकिन 5nm का मतलब यह नहीं है कि chip का हर transistor सचमुच 5 nanometer चौड़ा है। यह semiconductor manufacturing process generation का नाम है। छोटे process node से एक ही area में अधिक transistors लगाने और power efficiency सुधारने के अवसर मिलते हैं।
M1 में Apple ने इसी transistor budget का इस्तेमाल सिर्फ CPU को बड़ा बनाने में नहीं किया। उस जगह में CPU, GPU, Neural Engine, memory-related circuitry, security, media और दूसरे blocks को एक साथ रखा गया। यही वजह है कि M1 को केवल “एक तेज processor” कहने से इसकी पूरी architecture समझ में नहीं आती।
M1 को खोलकर देखने पर क्या पता चलता है
M1 की अंदरूनी बनावट केवल Apple के diagrams से ही नहीं जानी गई।
TechInsights ने MacBook Air A2337 से निकाले गए Apple M1 APL1102 का detailed digital floorplan analysis किया। इसमें package और die photographs, X-ray, SEM images और die पर मौजूद प्रमुख functional blocks की पहचान जैसी analysis शामिल थी।
इस तरह की teardown analysis से chip के अंदर अलग-अलग blocks की physical placement को समझने में मदद मिलती है।
लेकिन हर internal detail public नहीं है। Apple की पूरी floorplan design, individual blocks की exact internal implementation और कई low-level engineering details proprietary हैं। इसलिए किसी भी M1 anatomy में जो चीज public teardown से स्पष्ट नहीं है, उसे अनुमान के रूप में ही दिखाना चाहिए।
MacBook Air में fan क्यों नहीं था
M1 की architecture का एक practical example MacBook Air था। 2020 का M1 MacBook Air fanless design के साथ आया। यह इसलिए संभव हुआ क्योंकि M1 को शुरुआत से performance और power efficiency को साथ लेकर बनाया गया था।
Apple ने M1 को low-power Mac systems के लिए optimize किया था और अपने पुराने Mac systems की तुलना में performance-per-watt में बड़ा सुधार बताया था। MacBook Air में इसका मतलब था कि सामान्य काम करते समय active fan की जरूरत नहीं पड़ती थी।
लेकिन इसका मतलब यह नहीं है कि M1 किसी भी workload में गर्म नहीं होता। जब chip को लंबे समय तक भारी workload दिया जाता है तो वह heat पैदा करता है। Fanless design का मतलब केवल इतना है कि MacBook Air में उस heat को संभालने के लिए active fan नहीं लगाया गया था।
M1 किन Macs में आया
M1 की शुरुआत तीन प्रमुख Mac products से हुई:
- MacBook Air
- 13-inch MacBook Pro
- Mac mini
MacBook Air में 7-core और 8-core GPU दोनों configurations मिले, जबकि 13-inch MacBook Pro और Mac mini के M1 versions में 8-core GPU था।
यानी एक ही M1 नाम होने के बावजूद हर device में बिल्कुल समान GPU configuration नहीं था।
M1 ने आगे क्या रास्ता बनाया
M1 की सबसे बड़ी उपलब्धि केवल उसकी उस समय की performance नहीं थी।
इसने दिखाया कि Apple एक ही SoC architecture में CPU, GPU, memory system, machine learning, security और media processing को Mac के लिए एक साथ design कर सकता है। इसके बाद Apple ने इसी Apple Silicon approach को अधिक बड़े और अधिक powerful chips में आगे बढ़ाया।
इसलिए M1 को बाद के M1 Pro, M1 Max और M1 Ultra से अलग करके देखना मुश्किल है। वह पूरी Mac chip strategy की शुरुआत था।
M1 की सीमाएं भी थीं
M1 को केवल उपलब्धियों की सूची की तरह देखना सही नहीं होगा। सबसे स्पष्ट सीमा memory capacity थी। शुरुआती M1 Macs में unified memory अधिकतम 16GB तक configurable थी। कुछ professional workloads के लिए बाद में Apple को इससे बड़े memory और compute configurations वाले chips लाने पड़े।
दूसरी बात यह है कि M1 की integrated GPU बहुत सक्षम थी, लेकिन हर professional graphics workload में यह dedicated high-end GPU का replacement नहीं थी। और तीसरी बात, M1 की architecture के कारण memory बाद में upgrade करना संभव नहीं था।
इसलिए M1 का design हर उपयोगकर्ता के लिए एक जैसा फायदा नहीं देता था।
M1 की Anatomy एक नजर में
| हिस्सा | M1 में क्या था | इसका काम |
| CPU | 8 cores | General computing |
| Performance CPU | 4 cores | भारी CPU workloads |
| Efficiency CPU | 4 cores | कम power वाले workloads |
| GPU | 7 या 8 cores | Graphics और parallel workloads |
| Neural Engine | 16 cores | Machine learning |
| Unified Memory | 8GB / 16GB configurations | CPU, GPU और दूसरे blocks के लिए shared memory |
| ISP | Apple-designed | Image processing |
| Media hardware | Dedicated blocks | Video-related processing |
| Secure Enclave | Integrated security hardware | Security-sensitive operations |
| Process | 5nm | High transistor density और efficiency |
| Transistors | 16 billion | पूरे SoC की computing और control circuitry |
तो M1 की असली कहानी क्या थी?
M1 की खासियत यह नहीं थी कि उसमें आठ CPU cores थे या 16-core Neural Engine था।
असली बदलाव यह था कि Apple ने Mac को एक ऐसे architecture पर डाल दिया जिसमें CPU, GPU, memory और specialized hardware को अलग-अलग components की तरह नहीं, बल्कि एक ही system के हिस्सों की तरह design किया गया।
Unified memory ने data movement का तरीका बदला। Dedicated accelerators ने CPU पर हर काम डालने की जरूरत कम की। 5nm process ने बड़े transistor budget को relatively छोटे और efficient package में रखने की जगह दी। और Apple के hardware तथा macOS के बीच ज्यादा सीधा integration संभव हुआ। यही कारण है कि M1 को Apple की एक और तेज chip की तरह देखना इसकी कहानी को छोटा कर देता है।
M1 ने Mac के अंदर chip की भूमिका ही बदल दी।
Source: Official Apple Newsroom & Tech Specs, TechInsights M1 APL1102 Digital Floorplan Analysis.
iPhone 15 Pro हाथ में लेने पर A17 Pro की सबसे बड़ी उपलब्धि दिखाई नहीं देती। बाहर से फोन वही काम करता है जो दूसरा smartphone करता है: apps खोलना, camera चलाना, video record करना और games खेलना। सारा बदलाव चिप के अंदरूनी आर्किटेक्चर में था।
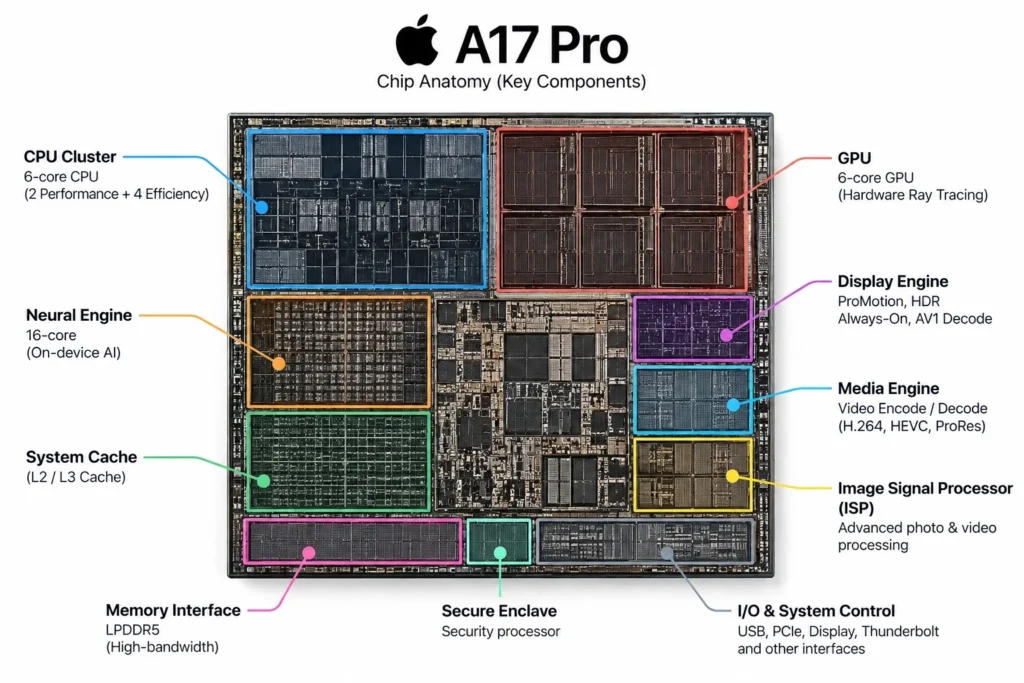
A17 Pro के साथ Apple ने iPhone में 3nm process पहली बार इस्तेमाल किया। Apple ने इसे industry का पहला 3-nanometer chip बताया था। इसी chip में CPU architecture में बदलाव, नया 6-core GPU, hardware ray tracing, तेज Neural Engine, dedicated AV1 decoder और USB 3 controller जैसी चीजें एक साथ आईं।
इसलिए A17 Pro की कहानी सिर्फ “3nm पर बनी नई Apple chip” कहकर खत्म नहीं होती। दिलचस्प हिस्सा यह है कि छोटे manufacturing process से मिली transistor density और efficiency को Apple ने chip के किन हिस्सों में इस्तेमाल किया।
3nm Node और Transistor Budget की असली कहानी
A17 Pro को TSMC के 3nm process पर बनाया गया था। TechInsights की analysis भी इसे TSMC 3nm FinFET process से बनी application processor के रूप में पहचानती है।
यहां 3nm को लेकर एक आम गलतफहमी दूर करना जरूरी है। इसका मतलब यह नहीं है कि chip के अंदर हर transistor का कोई physical dimension ठीक 3 nanometer है। Process node semiconductor manufacturing की पूरी technology generation को दर्शाता है।
छोटे process node का असली फायदा transistor density और power efficiency में मिलता है। A17 Pro में लगभग 19 billion transistors थे, जो A16 Bionic के 16 billion से काफी ज्यादा हैं। लेकिन transistor count अकेले performance नहीं बताता।
Apple ने इस अतिरिक्त transistor budget को सिर्फ CPU तक सीमित नहीं रखा, बल्कि उसे CPU, GPU, Neural Engine, media processing, connectivity और security के बीच अलग-अलग allocate किया — यही वजह थी कि हर हिस्से को अपने हिसाब से efficiency मिली।
CPU vs GPU: असली बदलाव कहां हुआ?
A17 Pro का CPU 6-core था, जिसमें 2 performance cores और 4 efficiency cores दिए गए। Apple ने पिछली पीढ़ी की तुलना में up to 10% faster performance का दावा किया था।
लेकिन A17 Pro का सबसे बड़ा architectural बदलाव GPU में दिखाई देता है:
- 6-Core GPU Redesign: A16 Bionic के 5-core GPU के मुकाबले Apple ने इसे 6-core GPU दिया और इसे iPhone GPU का सबसे बड़ा redesign बताया, जिसमें up to 20% faster graphics performance का दावा किया गया।
- Hardware-Accelerated Ray Tracing: नई GPU architecture में hardware ray tracing आया, जो software-based ray tracing की तुलना में 4x faster था।
- Console-Level Gaming: Ray tracing के लिए dedicated hardware देने से Resident Evil Village, Resident Evil 4 और Death Stranding Director’s Cut जैसे console-level games iPhone 15 Pro पर संभव हो सके।
हर काम को general-purpose CPU से करवाना जरूरी नहीं। जब किसी खास workload (जैसे gaming graphics) का इस्तेमाल बढ़ता है, तो dedicated hardware बनाना ज्यादा efficient होता है — A17 Pro के GPU redesign में यही सोच दिखती है।
On-Device AI, Video Processing और USB 3 Controller
A17 Pro केवल raw computing तक सीमित नहीं था, इसमें रोजमर्रा के कामों के लिए कई specialized blocks जोड़े गए:
- 16-Core Neural Engine: यह A16 की तुलना में up to 2x faster था। इसका इस्तेमाल iOS के autocorrect और Personal Voice जैसे on-device machine learning features में होता है।
- Dedicated AV1 Decoder: high-quality video playback का बोझ CPU पर डाले बिना efficient decoding के लिए इसमें dedicated AV1 decoder दिया गया।
- USB 3 Support: A17 Pro के नए USB controller की बदौलत iPhone पर पहली बार up to 10 Gbps transfer speed वाली USB 3 speeds का support मिला।
- Computational Photography: Sensor से आने वाले raw data को final image में बदलने, noise कम करने और multi-frame processing को संभालने में इसके कस्टम इमेज ब्लॉक काम करते हैं।
A17 Pro की Anatomy और Packaging
A17 Pro की physical Anatomy को समझने के लिए TechInsights की teardown और floorplan analysis काफी उपयोगी है।TechInsights ने iPhone 15 Pro से निकाले गए A17 Pro APL1V02 processor के TMQG36 die का digital floorplan analysis किया, जिसमें logic और functional regions को पहचाना गया। इसके साथ ही processor एक package-on-package (PoP) configuration में था, जिसमें application processor के ऊपर DRAM package किया गया था। analyzed package का आकार लगभग 17.0 × 12.87 × 0.91 mm था।
Smartphone में जगह बहुत सीमित होती है, इसलिए silicon die के साथ-साथ packaging technology भी architecture जितनी ही महत्वपूर्ण हो जाती है।
A17 Pro की Anatomy एक नजर में
| हिस्सा | A17 Pro में | मुख्य भूमिका |
| CPU | 6-core | General computing |
| Performance cores | 2 cores | Heavy CPU workloads |
| Efficiency cores | 4 cores | कम power वाले workloads |
| GPU | 6-core | Graphics और parallel processing |
| Ray tracing | Hardware accelerated | Realistic lighting और reflections |
| Neural Engine | 16-core | Machine learning |
| Transistors | लगभग 19 billion | पूरे SoC की circuitry |
| Process | TSMC 3nm | Semiconductor manufacturing |
| Video | Dedicated AV1 decoder | AV1 video decoding |
| USB | USB 3, up to 10 Gbps | High-speed data transfer |
| Package | Package-on-Package (PoP) | Processor और DRAM integration |
A17 Pro को केवल 3nm की वजह से याद रखना इसकी कहानी को छोटा कर देता है।
3nm process के साथ hardware ray tracing और console-level games आए। Efficient CPU cores और तेज Neural Engine के साथ-साथ USB 3, AV1 decoding और ज्यादा capable GPU भी मिले। Apple का उद्देश्य केवल phone को सामान्य कामों में तेज करना नहीं था, बल्कि उस hardware को ऐसे heavy workloads के लिए तैयार करना था जो पहले smartphone पर मुश्किल माने जाते थे।
3nm सिर्फ शुरुआत थी। असली बदलाव इस बात में था कि Apple ने उस छोटे process से मिली transistor density और efficiency को chip के अंदर सही कामों के लिए इस्तेमाल किया।
Source: Official Apple Newsroom & Technical Announcements, Apple A17 Pro Specifications, TechInsights A17 Pro Digital Floorplan, CPU/GPU & 3nm Process Analysis.
स्पेक शीट पर A18 Pro को देखकर पहली नजर में कोई बहुत बड़ा बदलाव नहीं दिखता। 6-core CPU, 6-core GPU और 16-core Neural Engine — core counts लगभग वही हैं जिनसे A17 Pro को पहचाना जाता था। फिर A18 Pro को Apple ने iPhone 16 Pro की सबसे महत्वपूर्ण upgrades में क्यों रखा?
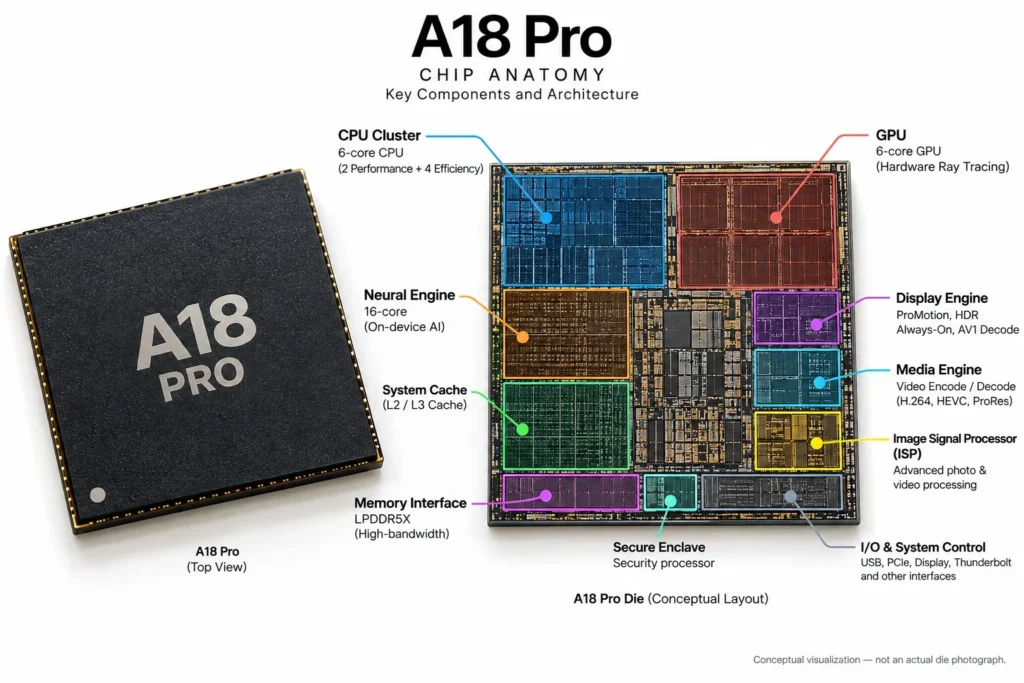
इसका जवाब सिर्फ नए cores में नहीं मिलता। A18 Pro में Apple ने ज्यादा ध्यान CPU architecture, memory bandwidth, cache, machine-learning acceleration, graphics और imaging pipeline के बीच के रिश्ते पर दिया है। यही वजह है कि chip को सिर्फ “6+6+16” configuration से समझना अधूरा रहेगा।
और A18 Pro की असली anatomy को समझने के लिए एक चीज जरूरी है: Apple बहुत कम internal details publicly बताता है। इसलिए जहां Apple ने specification दी है, उसे अलग रखना होगा और जहां TechInsights ने physical die analysis से कुछ देखा है, उसे अलग। दोनों sources अलग-अलग तरह की जानकारी देते हैं, और उन्हें एक ही certainty के साथ पढ़ना सही नहीं होगा।
3nm से शुरुआत, लेकिन कहानी सिर्फ 3nm की नहीं है
A18 Pro TSMC की second-generation 3nm process technology, N3E पर बना है। A17 Pro पहली-generation 3nm N3B process पर था। Apple के लिए यह process change सिर्फ manufacturing label बदलने भर की बात नहीं है; नए process के साथ transistor technology और chip-level design choices भी बदलती हैं। Apple A18 Pro को smaller और faster transistors वाली नई architecture के रूप में describe करता है।
TechInsights की A18 Pro die analysis के अनुसार इसका processor footprint A17 Pro की तुलना में करीब 3% छोटा है (अनुमानित ~105 mm²)। यानी A18 Pro को सिर्फ “3nm होने के कारण बहुत छोटा chip” मानना पूरी तस्वीर नहीं देता। Analysis में लगभग वही overall silicon area रखते हुए CPU, GPU, cache, NPU और memory interfaces की placement और proportions में बदलाव दिखाई देते हैं।
A18 Pro का exact transistor count Apple ने officially publish नहीं किया है। Die area और transistor count एक ही चीज नहीं हैं, खासकर जब manufacturing process और अलग-अलग circuit blocks की density भी बदल रही हो — इसलिए A17 Pro के known count से A18 Pro के लिए कोई अनुमान निकालना भरोसेमंद तरीका नहीं होगा।
CPU में core count वही, efficiency का खेल अलग
A18 Pro का CPU 6-core configuration रखता है: 2 performance cores + 4 efficiency cores। Apple के अनुसार यह पिछले generation के मुकाबले समान workload को up to 15% faster पूरा कर सकता है और उसी workload में 20% तक कम power इस्तेमाल करता है।
यहां core count से ज्यादा महत्वपूर्ण यह है कि cores और बाकी chip resources किस तरह साथ काम करते हैं।
TechInsights के floorplan में A18 Pro के CPU area के साथ एक बड़ा L3 cache region दिखाई देता है। Cache CPU के बहुत पास रहने वाली तेज memory होती है। जब processor को बार-बार इस्तेमाल होने वाला data वहीं मिल जाता है, तो हर बार system memory तक जाने की जरूरत कम हो सकती है। इससे latency और memory traffic दोनों पर असर पड़ता है।
TechInsights ने यह भी पाया कि A18 Pro के performance cores में Apple के M-series processors से मिलते-जुलते design characteristics दिखाई देते हैं। यह पूरी CPU architecture की पुष्टि नहीं करता, लेकिन Apple के अलग-अलग chip families में design ideas share करने की दिशा जरूर दिखाता है।
इसलिए A18 Pro का CPU upgrade सिर्फ clock speed की कहानी नहीं है।
GPU: 6 cores ही हैं, लेकिन performance में बड़ा बदलाव
A18 Pro में 6-core GPU है। Apple के मुताबिक यह previous generation की तुलना में up to 20% faster है। Hardware-accelerated ray tracing को भी Apple ने up to 2x faster बताया है।
A18 Pro ने GPU cores की संख्या बढ़ाए बिना performance बढ़ाने पर काम किया है। GPU workloads में data लगातार memory और cache के बीच चलता रहता है। Compute units तेज होने के बावजूद अगर data समय पर उपलब्ध न हो, तो theoretical performance पूरी तरह इस्तेमाल नहीं हो पाती।
इसीलिए A18 Pro का wider memory system भी महत्वपूर्ण है। System memory bandwidth में 17% increase CPU, GPU और Neural Engine तीनों के लिए अतिरिक्त data throughput देता है।
Apple का “up to 2x faster” ray-tracing claim एक maximum, best-case number है। असल result game engine, workload और software optimization के हिसाब से अलग-अलग होगा।
Neural Engine के पीछे भी पूरा AI subsystem है
A18 Pro में 16-core Neural Engine है और Apple इसे previous generation की तुलना में faster और more efficient बताता है। इसका मुख्य काम on-device machine-learning workloads को efficiently execute करना है।
लेकिन A18 Pro की AI processing केवल Neural Engine तक सीमित नहीं है। Apple ने CPU में next-generation ML accelerators भी जोड़े हैं। Apple के अनुसार ये high-efficiency, high-throughput और low-latency machine-learning computations को CPU side पर handle कर सकते हैं। इससे हर छोटे operation के लिए dedicated Neural Engine का इस्तेमाल जरूरी नहीं पड़ता।
Architecture के लिहाज से यह distinction महत्वपूर्ण है। Dedicated Neural Engine specialized ML workloads के लिए है, जबकि CPU-side accelerators कुछ दूसरे ML operations को कम overhead में संभाल सकते हैं।
TechInsights की physical floorplan analysis में A18 Pro के NPU area में 8-core configuration जैसा arrangement दिखाई देता है। Individual NPU cores A17 Pro की तुलना में लगभग 10% छोटे बताए गए हैं, जबकि shared logic और cache area लगभग 15% बड़ा दिखाई देता है।
यहां terminology अलग-अलग sources की है। Apple अपनी public specification में 16-core Neural Engine कहता है, जबकि TechInsights का floorplan analysis physical NPU cluster की अलग characterization देता है — ये दो अलग तरह के measurements हैं, इसलिए इन्हें सीधे एक-दूसरे से contradict करते हुए नहीं पढ़ना चाहिए।
Apple ने cache और logic area में हुए इस बदलाव के लिए कोई exact “AI performance में X% improvement” वाला आंकड़ा officially नहीं दिया है, इसलिए TechInsights के observations से ऐसा कोई percentage निकालना संभव नहीं है।
Memory: A18 Pro की छुपी हुई ताकत
A18 Pro की performance story में memory system शायद सबसे कम दिखाई देने वाला, लेकिन महत्वपूर्ण हिस्सा है। TechInsights ने A18 Pro floorplan में 4 LPDDR5X interfaces identify किए हैं। A17 Pro के LPDDR5 memory system से यह एक generation-level change है।
Apple ने पूरे system memory bandwidth में 17% increase बताया है। CPU, GPU और Neural Engine सभी data पर निर्भर हैं, इसलिए memory subsystem में सुधार का असर कई अलग workloads में दिखाई दे सकता है।
Processor के पास कितनी computing capacity है और उस capacity तक data कितनी तेजी से पहुंचता है — दोनों अलग चीजें हैं। A18 Pro में Apple ने इन दोनों के बीच के balance को बेहतर करने पर काम किया है।
Cache: die पर छोटा दिखने वाला, architecture में महत्वपूर्ण
A18 Pro के floorplan में cache को नजरअंदाज करना मुश्किल है। TechInsights ने एक large L3 cache region identify किया है।
Cache का फायदा सिर्फ CPU को तेज data देने तक सीमित नहीं है। बड़े shared cache structures processor को बार-बार external memory access करने से बचा सकते हैं, जिससे latency कम हो सकती है और memory traffic घट सकता है।
AI side पर भी TechInsights ने NPU के आसपास shared logic और cache area बढ़ा हुआ पाया है। इससे यह संकेत मिलता है कि Apple ने compute cores के साथ-साथ data movement और shared resources पर भी ध्यान दिया है।
फिर भी, physical floorplan में किसी block का area कितना बड़ा दिखता है और उस block का exact software-level performance पर योगदान कितना है — ये दो अलग सवाल हैं, और floorplan अकेले दूसरे का जवाब नहीं देता।
Camera और video में A18 Pro का दूसरा बड़ा काम
A18 Pro सिर्फ CPU और GPU वाला application processor नहीं है। इसकी imaging capabilities भी iPhone 16 Pro के camera system का महत्वपूर्ण हिस्सा हैं।
Apple ने A18 Pro में नया Image Signal Processor (ISP) और video encoder दिया है और कहा है कि इनकी data-processing capacity previous generation की तुलना में 2x है।
ISP camera sensor से आने वाले raw image data को process करने वाली pipeline का हिस्सा है। Exposure, colour, noise और computational photography जैसे कई operations इसी broader imaging pipeline से जुड़े होते हैं। Video encoder processed frames को compressed video format में encode करता है।
इसी hardware-software combination के साथ iPhone 16 Pro में 4K 120fps Dolby Vision video और 4K 120fps ProRes/Log recording जैसे workflows मिलते हैं। Apple ने 4K120 Dolby Vision के साथ नए A18 Pro ISP की frame-by-frame colour grading capability भी highlight की है।
Camera sensor, ISP, video encoder, memory system, storage और software pipeline — ये सब मिलकर पूरा imaging system बनाते हैं, इसलिए इन capabilities का credit अकेले ISP को देना अधूरी तस्वीर होगी।
Display, media और बाकी system blocks
A18 Pro का काम सिर्फ heavy computation तक सीमित नहीं है। iPhone 16 Pro का display system Always-On और ProMotion जैसी capabilities के साथ काम करता है, जबकि media और imaging workloads को अलग hardware blocks support करते हैं।
Apple ने A18 Pro को graphics-intensive gaming, computational photography और Apple Intelligence जैसे workloads के लिए design किया है। SoC के अंदर specialized blocks एक-दूसरे के साथ मिलकर काम करते हैं; CPU हर workload अकेले handle नहीं करता।
यही modern smartphone SoC की खासियत है। CPU और GPU के अलावा data movement, memory access, security और dedicated accelerators भी overall performance का हिस्सा हैं।
Security: Secure Enclave चिप का अलग सुरक्षित हिस्सा है
A18 Pro जैसी Apple SoC में security hardware भी architecture का हिस्सा है। Secure Enclave Apple SoC में integrated dedicated secure subsystem है और main processor से isolated रहता है। इसका उद्देश्य sensitive data और cryptographic operations के लिए अलग security boundary उपलब्ध कराना है।
Apple के documentation के अनुसार Secure Enclave में अपना Boot ROM, Secure Enclave Processor, AES Engine, protected memory mechanisms, random-number generation और public-key cryptography support जैसे hardware components होते हैं। इसका महत्वपूर्ण हिस्सा silicon में ही मौजूद रहता है।
A18 Pro की anatomy में security को main CPU का हिस्सा मानने के बजाय एक isolated secure subsystem के तौर पर देखना ज्यादा सटीक है।
USB और external data workflow
iPhone 16 Pro में USB 3 speeds up to 10Gbps का support भी है। High-resolution video files और ProRes workflows के लिए यह practical difference बनता है, खासकर जब footage को external storage पर transfer या record किया जाता है। Apple ने 4K120 ProRes और Log recording को external storage workflows के साथ भी highlight किया है।
SoC और पूरे phone की anatomy को अलग रखना भी जरूरी है। iPhone की connectivity architecture में cellular baseband जैसे components A18 Pro die के अंदर simply एक और block की तरह नहीं रखे जाते। A18 Pro की die anatomy और पूरे iPhone motherboard की anatomy दो अलग चीजें हैं।
A18 Pro के die floorplan में क्या दिखाई देता है?
TechInsights की physical analysis A18 Pro को सिर्फ specification sheet से कहीं ज्यादा दिलचस्प बनाती है। Analysis के मुताबिक die में मुख्य रूप से ये areas identify किए गए हैं:
| Block | A18 Pro में क्या दिखता है |
|---|---|
| CPU | 2 performance + 4 efficiency cores |
| GPU | 6 cores |
| NPU | 8-core physical configuration (TechInsights analysis) |
| Memory Interface | 4 LPDDR5X interfaces |
| Cache | बड़ा L3 cache region |
| Process | TSMC N3E (2nd Gen 3nm) |
| Die Footprint | A17 Pro से करीब 3% छोटा |
TechInsights ने N3E के साथ finFLEX technology के इस्तेमाल के संकेत भी report किए हैं। Analysis में यह भी दिखता है कि A18 Pro ने अपने predecessor से बहुत अलग overall footprint अपनाने के बजाय उसी broad area में architectural changes किए हैं।
उपलब्ध floorplan evidence से तस्वीर यह बनती है कि Apple ने existing silicon area के भीतर अलग-अलग blocks की priority और resource distribution को बदला है।
A17 Pro से A18 Pro में असली बदलाव
| हिस्सा | A17 Pro | A18 Pro |
|---|---|---|
| Manufacturing | TSMC N3B | TSMC N3E |
| CPU | 6-core (2P+4E) | 6-core (2P+4E) |
| CPU Performance | — | Up to 15% faster |
| CPU Power | — | Up to 20% lower for same workload |
| GPU | 6-core | 6-core, up to 20% faster |
| Ray Tracing | Hardware accelerated | Up to 2x faster |
| Neural Engine | 16-core | 16-core |
| ML Acceleration | Previous generation | Next-generation CPU-side ML accelerators |
| Memory | LPDDR5 | LPDDR5X |
| System Memory Bandwidth | — | 17% higher |
| ISP / Video Encoder | Previous generation | 2x data-processing capacity |
Apple के official numbers और TechInsights के physical analysis को साथ रखकर देखें तो pattern साफ है: core counts में बदलाव सीमित है, लेकिन उन cores के आसपास का system ज्यादा महत्वपूर्ण तरीके से बदला गया है।
A18 और A18 Pro एक ही चिप नहीं हैं
A18 Pro को standard A18 का सिर्फ higher-clocked version समझना सही नहीं है। TechInsights ने A18 और A18 Pro के लिए अलग die markings और अलग die designs identify किए हैं। A18 Pro में 6-core GPU है, जबकि standard A18 में 5-core GPU है। TechInsights की analysis दोनों chips में 2+4 CPU configuration और 16-core NPU specification की ओर भी इशारा करती है, लेकिन overall silicon design अलग है।
Apple ने Pro और standard iPhone के लिए silicon level पर भी अलग priorities रखीं। Pro chip में ज्यादा graphics capability और imaging/video workloads के लिए अधिक headroom जैसी चीजें उस product positioning से जुड़ी हैं।
A18 Pro की सबसे बड़ी बात क्या है?
अगर A18 Pro को सिर्फ तीन numbers में लिखना हो — 6 CPU + 6 GPU + 16 Neural Engine — तो chip की सबसे दिलचस्प बात छूट जाएगी।
CPU core count वही रहा, लेकिन performance और efficiency दोनों में सुधार का दावा किया गया। GPU cores की संख्या वही रही, लेकिन GPU performance और ray tracing में बड़ा claimed jump आया। Neural Engine की public core count वही 16 है, जबकि CPU-side ML accelerators और NPU के आसपास के physical changes AI workload के लिए पूरी architecture को मजबूत करते हैं। Memory system LPDDR5X और 17% higher bandwidth के साथ आगे बढ़ता है। Cache और shared logic के लिए die area भी महत्वपूर्ण दिखाई देता है।
A18 Pro को सिर्फ एक और 3nm chip के रूप में देखना इसकी पूरी कहानी नहीं बताता।
इसी तरह TechInsights का floorplan कई important regions को identify करता है, लेकिन die पर दिखाई देने वाले हर छोटे area का exact purpose public documentation से तय नहीं किया जा सकता। NPU के shared cache और logic में increase दिखाई देना एक useful observation है, पर इससे अकेले कोई exact AI performance percentage नहीं निकलता।
Chip anatomy समझने में यह सीमा भी उतनी ही अहम है जितनी confirmed जानकारी। जहां evidence उपलब्ध नहीं है, वहां उसे अनुमान की जगह unknown ही रहने देना बेहतर approach है।
A18 Pro को खास तौर पर इसलिए देखा जाना चाहिए क्योंकि यह core-count race से ज्यादा system-level design का उदाहरण है। Apple ने CPU, GPU, Neural Engine, ML accelerators, cache, memory interfaces और imaging hardware को एक ऐसे SoC में जोड़ा है जिसमें अलग-अलग blocks एक-दूसरे की limitations को कम करने की कोशिश करते हैं।
A18 Pro की असली ताकत किसी एक block में नहीं, बल्कि इन blocks के बीच बने पूरे architecture में दिखाई देती है।
Source: Apple Newsroom, Apple Platform Security Documentation, और TechInsights की A18 / A18 Pro Digital Floorplan Analysis पर आधारित।
-
 Android3 weeks ago
MediaTek Dimensity 8300: मिड-रेंज से ऊपर जाने की असली कोशिश कहाँ थी?
-
 Android3 weeks ago
Dimensity 9300 की Anatomy: All Big Core डिजाइन ने स्मार्टफोन दुनिया को कैसे चौंकाया?
-
 Apple3 weeks ago
Apple M1 Chip की असली कहानी: एक चिप ने Mac को हमेशा के लिए कैसे बदल दिया?
-
 Apple3 weeks ago
Apple A17 Pro: 3nm की पहली छलांग ने iPhone की चिप में क्या बदल दिया?
-
 Android3 weeks ago
Qualcomm Snapdragon 8 Gen 2 की Anatomy: अंदर से यह चिप इतनी खास क्यों थी?
-
 Android3 weeks ago
Qualcomm Snapdragon 8 Elite: अंदर से कितनी बदली Qualcomm की सबसे ताकतवर मोबाइल चिप?
-
 Android3 weeks ago
MediaTek Dimensity 9400: एक अलग CPU strategy ने क्या बदल दिया?
-
 Apple3 weeks ago
Apple A19 Pro: iPhone की नई ताकत के पीछे छिपी चिप की पूरी कहानी